
當了這麼久呆呆龍,Gemini Argon 終於翻身?對比 Opus 5.5、GPT-6 Astra
林政賢 Zheng-Xian Lin ·
2026.10.20 查核|AI 日報完整報導。模型公告及各作品日期分別標示,不視為今天全部新發布。
AI 圈有一種排行榜,不看分數,看龍的表情。
Claude 跟 ChatGPT 在旁邊張牙舞爪,Gemini 卻常被安排成那顆眼神放空、舌頭掛在外面的「呆呆龍」。別人負責輸出,它像是負責搞笑。
現在,Gemini 4 Argon 帶著漂亮的成績單回來了,梗圖裡的它甚至開始全身冒火。
搞笑擔當當了這麼久,
這次終於可以反敗為勝了嗎?
先別急著替它加冕。我們把官方數字、第三方評測、真的能打開來看的作品擺在一起,發現最有意思的,不是哪隻龍比較兇,而是——同一隻龍,換一套工具,表現居然可以差這麼多。
想先讀哪一段?
Google 說很強。
翻開考卷,確實有料。
Google 在 9 月 30 日的 Argon 公告中,放了一張涵蓋多項能力的比較表。我們逐列核對:19 列中,Argon 有 13 列單獨最高、1 列並列最高,另外 5 列落後。注意,這是 Google 選定與公布的測試,不是「全世界所有測試贏了七成」。[1]
| 測什麼 | Argon | Astra | Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 軟體工程任務 | 77.9 | 74.1 | 74.2 |
| FrontierSWE v2 另一組軟體工程任務 | 55.0 | 65.5 | 62.3 |
| LVBench 長影片理解 | 91.7 | 87.5 | 83.7 |
光是兩種寫程式測試,第一名就會換人。這才是選模型最常遇到的現實:你做什麼,比誰的總分漂亮更重要。
換一家出題,冠軍也會換。
截至 10 月 20 日查詢,Artificial Analysis 的 Intelligence Index 顯示:Opus 5.5 為 58,Argon 和 Astra 均為 53;但在 AutomationBench-AA,Argon 又以 78%,高於 Opus 的 70% 與 Astra 的 68%。[2][3]
有沒有全面把另外兩家打趴?目前這些證據,不支持這樣下結論。
AA 比較設定為 Argon High、Opus Max Default Fallback、Astra Max,並非相同運算預算。Intelligence Index 也不是百分制;AutomationBench-AA 不能和 Google 表裡的 AutomationBench 混成同一題。
同一隻龍,
換個駕駛艙就不一樣。
創作者 OhMyUnicorn 做了一個很直觀的挑戰:給模型一張虛構軍艦的參考圖,請它寫 Blender 程式、產出模型,再看渲染結果修正。這次實際造船的對手是 Astra 和 Argon,不是三家都各造一艘。[4]
第一次,Argon 透過 Claude Code 的代理轉接執行,出現等待與卡住的問題。作者後來改用 Antigravity CLI 重跑,三種思考設定都順利完成;更新記錄認為,高設定的視覺品質已能跟 Astra 高設定相提並論。
高設定 · 156 個物件部件
高設定重測 · 11 個物件部件
部件多不等於比較漂亮,但如果接著要拆解、綁定或修改模型,結構差異就可能有影響。好看、好改、做得快,是三個不同的問題。
這也提醒我們:看別人說「某模型很笨」時,先問一句,它是腦袋不行,還是工具根本沒接好?
這是作者的單次作品記錄,不是我們重跑的實測。初次卡住的原因未被完全定位,不能全部算在模型頭上;兩者高設定的 API 計價等值約 $5.24 與 $5.36,Astra 實際用的是訂閱,這不是兩筆實付帳單。
看軍艦作品與重測記錄 ↗做小行星城市,也出現類似情況。
同一位作者讓模型做一顆可以轉動、放大觀看的小行星城市。Argon 換成 Antigravity CLI、能確實查看畫面後,作者認為成果更完整;但近看的細節,仍更喜歡 Opus 的版本。換工具能救回表現,並不保證每項細節都贏。[5]
三家都來做
一間 3D 風洞實驗室。
VisualForge Bench 公開了三家的可執行作品:車子、風線、相機和控制面板都直接做成網頁。我們已打開三份初始畫面,下面可直接前往原作操作。這是模型寫程式做出來的 3D 展示,不是 Argon 原生生成一支影片。[6]
GPT-6 Astra
橘色車體、較明亮的展示感,控制面板集中右側。
開啟可操作原作 ↗Claude Opus 5.5
紅車白條紋、風洞感更強,左右兩側配置控制與數據。
開啟可操作原作 ↗Gemini 4 Argon
紅黑車體配黃色線條,上方儀表列、右側長控制台。
開啟可操作原作 ↗- 第一眼:主角明不明確?字跟控制項好不好找?
- 動手玩:按鈕是否真的改變畫面,還是只有外觀?
- 接著改:若要換成你的品牌與商品,哪份最容易延伸?
我們目視檢查的是初始畫面,尚未逐一驗證全部按鈕、效能或手機互動。這些是示意風場,不能當工程 CFD 模擬;其中 Opus 的提示詞雜湊與另外兩份不同,不能宣稱三家完全相同提示詞的公平盲測。原站部分評分由 Opus 模型裁判產生,因此本篇不拿其平均分直接排冠軍。
影片由原作者測試頁連出,保留原始播放器與署名;本篇未逐段觀看全片,不把影片標題當評測結論。也可直接到 YouTube 觀看 ↗。
這次不是梗圖。
它們真的打敗了終界龍。
10 月 15 日公開的研究預印本,記錄了四個 Argon Agent 在 Minecraft 裡分工合作,從隨機世界開始,最終打敗終界龍。[8]
它們透過 Mineflayer 程式介面控制角色,在簡單難度下執行;不是像人一樣盯著螢幕、用鍵盤滑鼠玩,也沒有跟 Opus、Astra 做同條件對照。
所以這件事證明的,是長時間規劃、寫程式、犯錯再繼續的潛力。並不是「Argon 已經能接手你所有工作」。但不得不說,從被畫成呆呆龍,到真的組隊去打龍,這劇情還滿勵志的。
它有資格爭大哥。
但王位還沒坐穩。
Argon 有漂亮的官方成績,也有值得看的實際作品;換工具後的進步,讓我們更難用一張梗圖判它出局。另一方面,獨立評測與創作者成果都沒有呈現「全面輾壓」。
如果你拿 AI 做網站、影片工具或品牌素材,我會先把問題換掉:不要只問誰最強,改問誰能把我的這一份工作,做得更完整?
能不能交出來、交出來能不能用、要改時會不會整個壞掉。
同一份素材、同一個目標、相近的時間預算,連失敗與返工一起記下來。那會比替哪隻龍戴皇冠,更接近你真正要的答案。
下一張梗圖誰吐舌頭,還很難說。
先讓它們把作品交出來。
梗可以很兇,
結論不用急。
不同版本的三頭龍梗圖,確實常把 Gemini 畫成吐舌頭的搞笑擔當;也有把它畫成強者的反轉版。梗圖反映的是社群情緒,不是每代模型的效能排名。
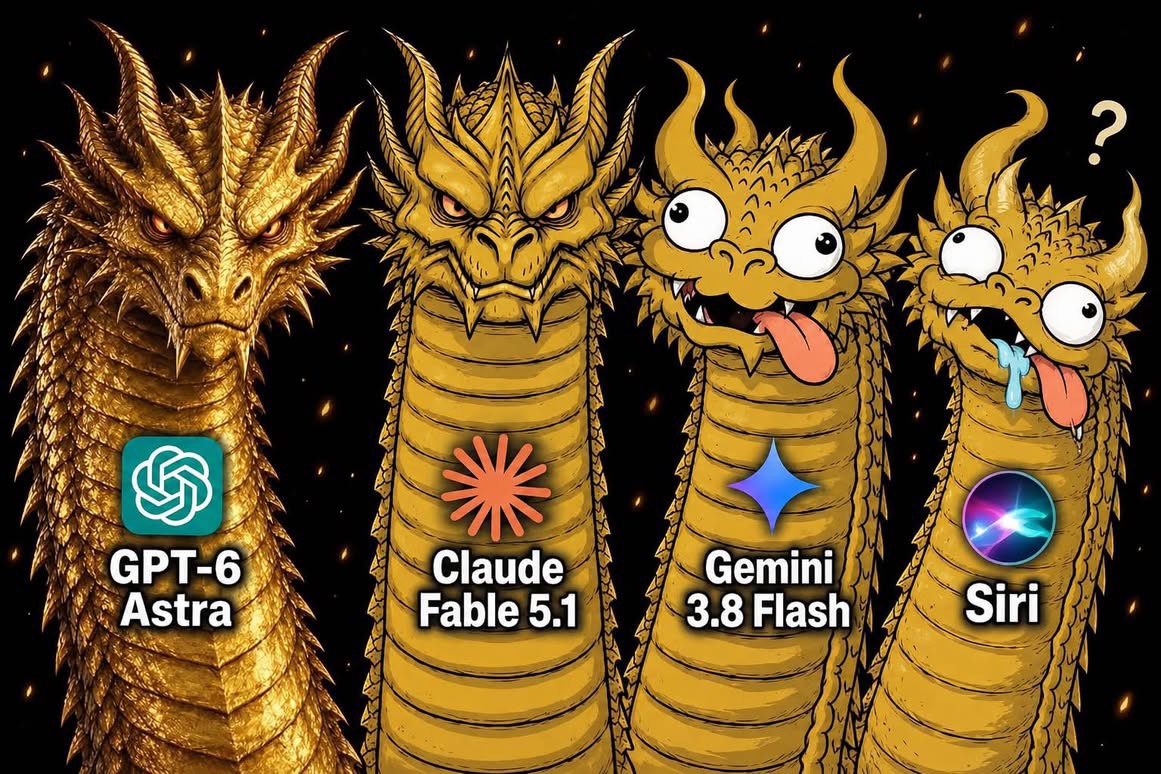
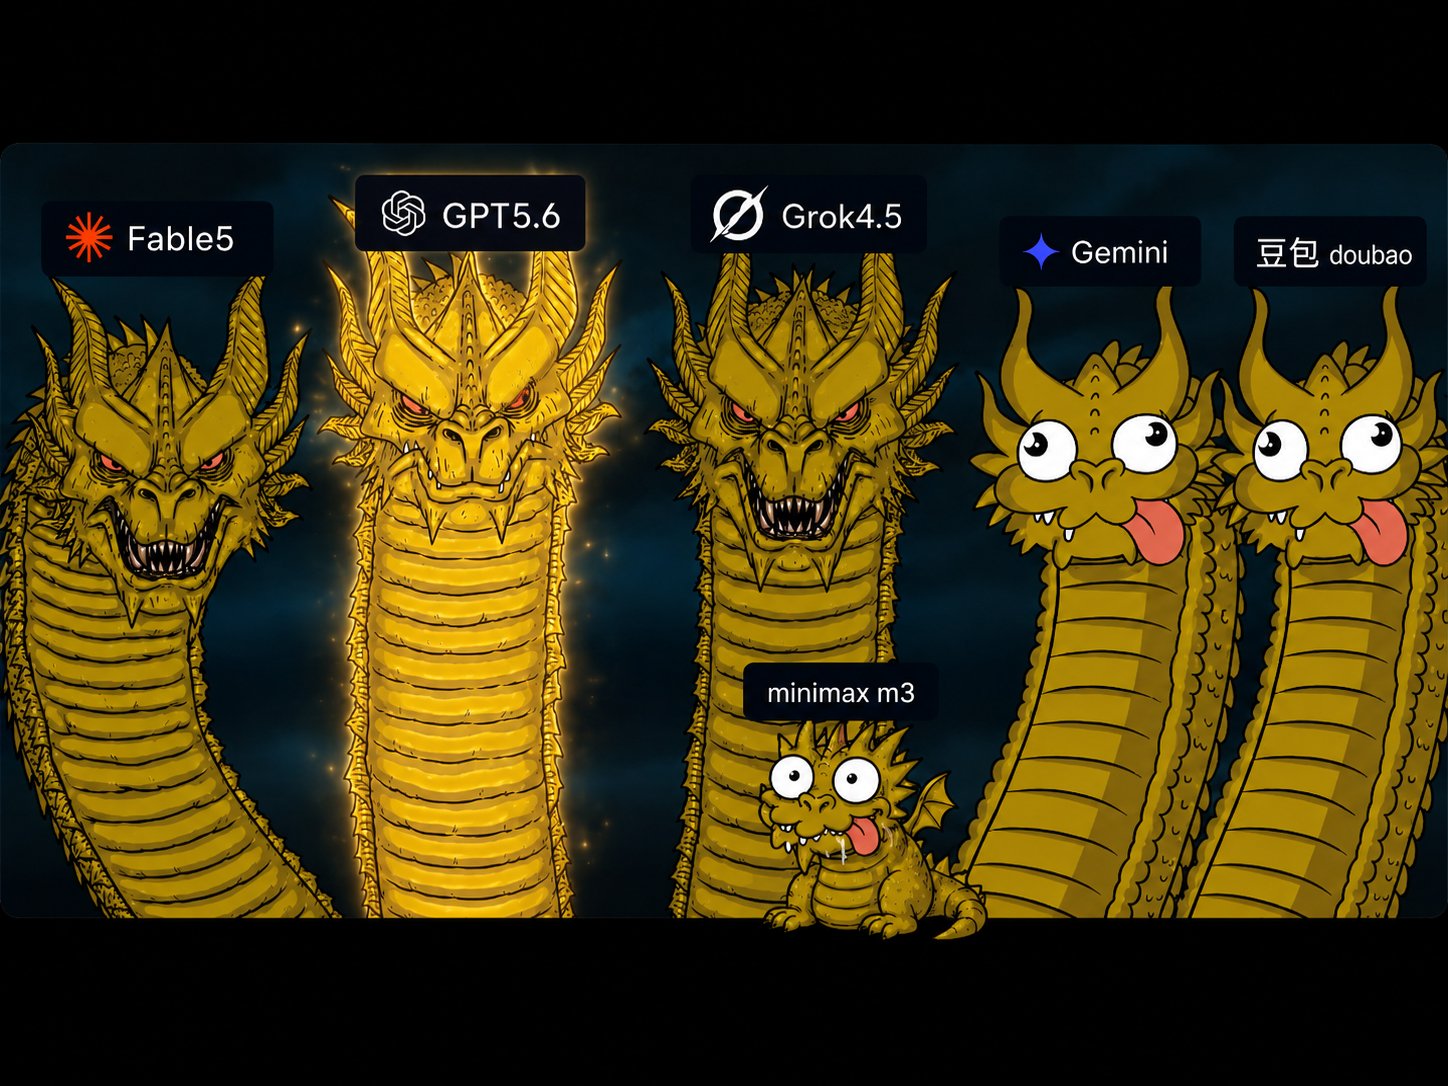
社群梗圖由讀者提供,僅用於本文評論,非效能評測。相關原貼與可核對資料列於文末;目前未找到完整核對每代日期及測試結果的歷史合集。
把原作留給你,
自己看,比只聽人說更有趣。
- Google:Gemini 4 Argon 公告與官方比較表 ↗2026-09-30;官方數據,非獨立重測
- Artificial Analysis:Argon 與 Opus 5.5 ↗2026-10-20 查詢;設定不同,指數不是百分制
- Artificial Analysis:Argon 與 GPT-6 Astra ↗2026-10-20 查詢
- OhMyUnicorn:Blender 軍艦測試與重測記錄 ↗2026-10-14;創作者單次測試,工具與模型共同影響結果
- OhMyUnicorn:小行星城市,Argon 換工具前後 ↗2026-10-14 更新;不是盲測
- VisualForge Bench:Argon 作品、測試記錄與影片 ↗2026-10-14;結果更新至 10-19,不採不同覆蓋率的平均分排冠軍
- VisualForge Bench 原作者評測影片 ↗由作者測試頁連出;本篇未逐段觀看整支影片
- Faldor 等人:四個 Argon Agent 完成 Minecraft ↗2026-10-15 預印本;研究團隊自述,非三模型對照實驗
- 社群梗圖:Gemini 與其他模型的三頭龍版本 ↗圖片搜尋找到;X 原文擷取受限,不推定發文日期或完整歷史
- 社群梗圖:把 Gemini 畫成強者的反轉版本 ↗圖片搜尋找到;同樣不是評測證據
- Reddit:Argon 公告後的龍梗圖討論 ↗社群反應;不使用頁面相對日期判定時間線
- Anthropic:Claude Opus 5.5 官方說明 ↗2026-09-22
- OpenAI:GPT-6 Astra 模型文件 ↗確認比較對象為 Astra,不混入 Sol
- Google:Argon 模型文件 ↗模型輸出文字;本篇 3D 範例是寫程式產生作品
本文為資料查核與有限的作品頁目視比較;未在本機重新執行這三個模型。第三方作品採原連結/原始嵌入,不下載重製影片,也不假設公開可看就等於可任意轉載。模型、指數與工具可用性會更新,數值以 2026-10-20 本次查詢為準。
作者:林政賢(導演 · Gen AI 創作者兼工程師 · 瑭宜影像創意工作室創辦人)