
NVIDIA 幫病毒蛋白質畫「立體地圖」:AI 預測之後,科學家還要做什麼?
林政賢 Zheng-Xian Lin ·
AI 已經能畫出病毒蛋白質的立體形狀,是不是代表疫苗也快能一鍵生成?先別急著把實驗室關掉。這次 NVIDIA 帶來的消息,更像是替研究者準備一份可以查閱、比較的地圖:它能指引探索方向,卻不會替你走完旅程。
這次開放的是什麼?
NVIDIA 在 2026 年 9 月 24 日公告,與 Google DeepMind、EMBL-EBI 及其他研究團隊合作,將涵蓋超過 2,800 種病毒的蛋白質複合體預測結構,透過 AlphaFold Database 開放給研究者使用。[1]
「複合體」可以先想成幾個零件組成的小組。研究者不只關心某個蛋白質自己的樣子,也想知道它和其他蛋白質可能如何組合。這裡的立體模型是電腦推算的結果,並非替每個組合拍下實驗照片。
資料庫的更新說明進一步列出:這項合作分析了 23 個與人類健康相關病毒家族的 2,812 個病毒蛋白質體,產生 5,279 個高信心異源二聚體與 2,749 個高信心同源二聚體。前者可白話理解為兩個不同蛋白質的組合,後者則是相同蛋白質的配對。[2]
這些數字各有單位,不能把「分析多少個蛋白質體」寫成「發現多少種新病毒」,也不能把結構數量當成可用藥物數量。
NVIDIA 做的,不只是把圖算得漂亮
NVIDIA 同時公開 BioNeMo Structure Prediction Pipeline。依專案說明,它把序列資料處理、結構預測與後續品質評估接成可在 GPU 叢集執行的工作流程。[3]
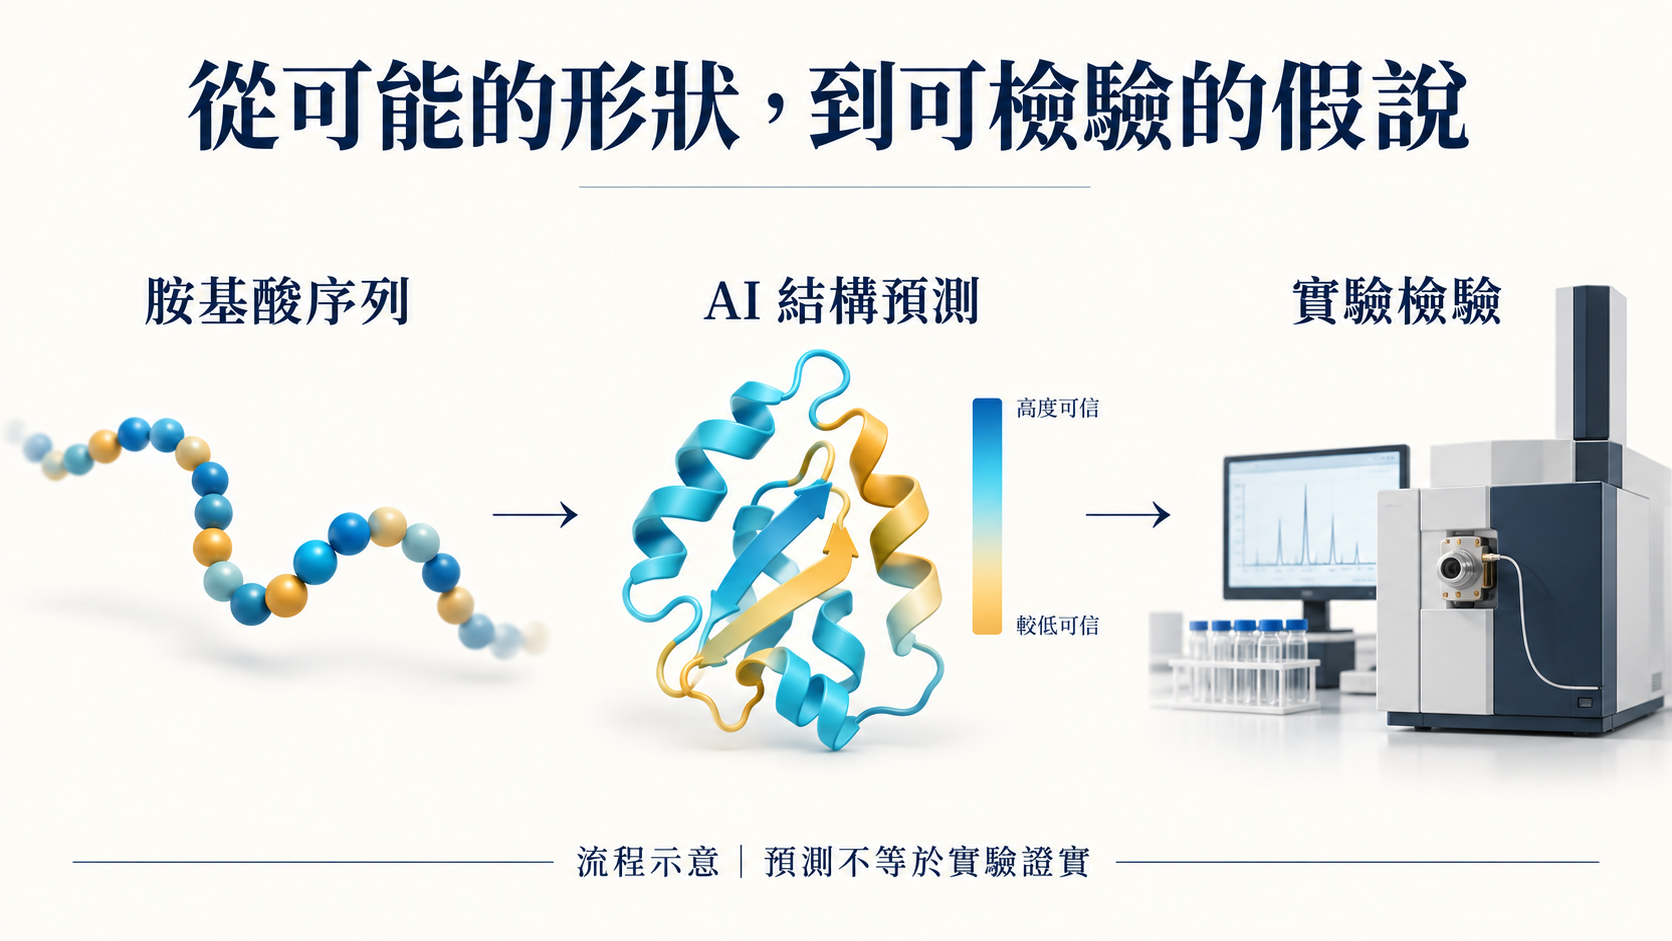
這提供了另一個看 AI 的角度:有價值的成果,除了模型本身,也包括資料如何準備、結果如何檢查,以及其他人能不能接著使用。做過影像專案的人應該很熟悉這種差別——產出一張圖,和建立可交接的製作流程,是兩個層次。
不過,開放程式不代表家用電腦下載後就能輕鬆重跑。專案列出的環境包括 Slurm 叢集,以及至少 80GB 記憶體的 NVIDIA GPU 等需求。對一般讀者而言,查閱既有資料,與自行執行完整預測流程,是不同的門檻。[3]
一張結構圖,回答不了所有問題
EMBL 的公告特別說明:預測結構可以呈現蛋白質可能的外形與相互作用,但單靠這些資訊,不能知道病毒實際如何表現,也不能直接判斷變異造成的影響;這仍需實驗研究。[4]
所以看到新聞裡的「高信心」,比較恰當的理解是模型對特定預測的信心,不是疫苗有效率,也不是某種治療已經安全有效。把這些詞混在一起,故事會很刺激,資訊卻會走樣。
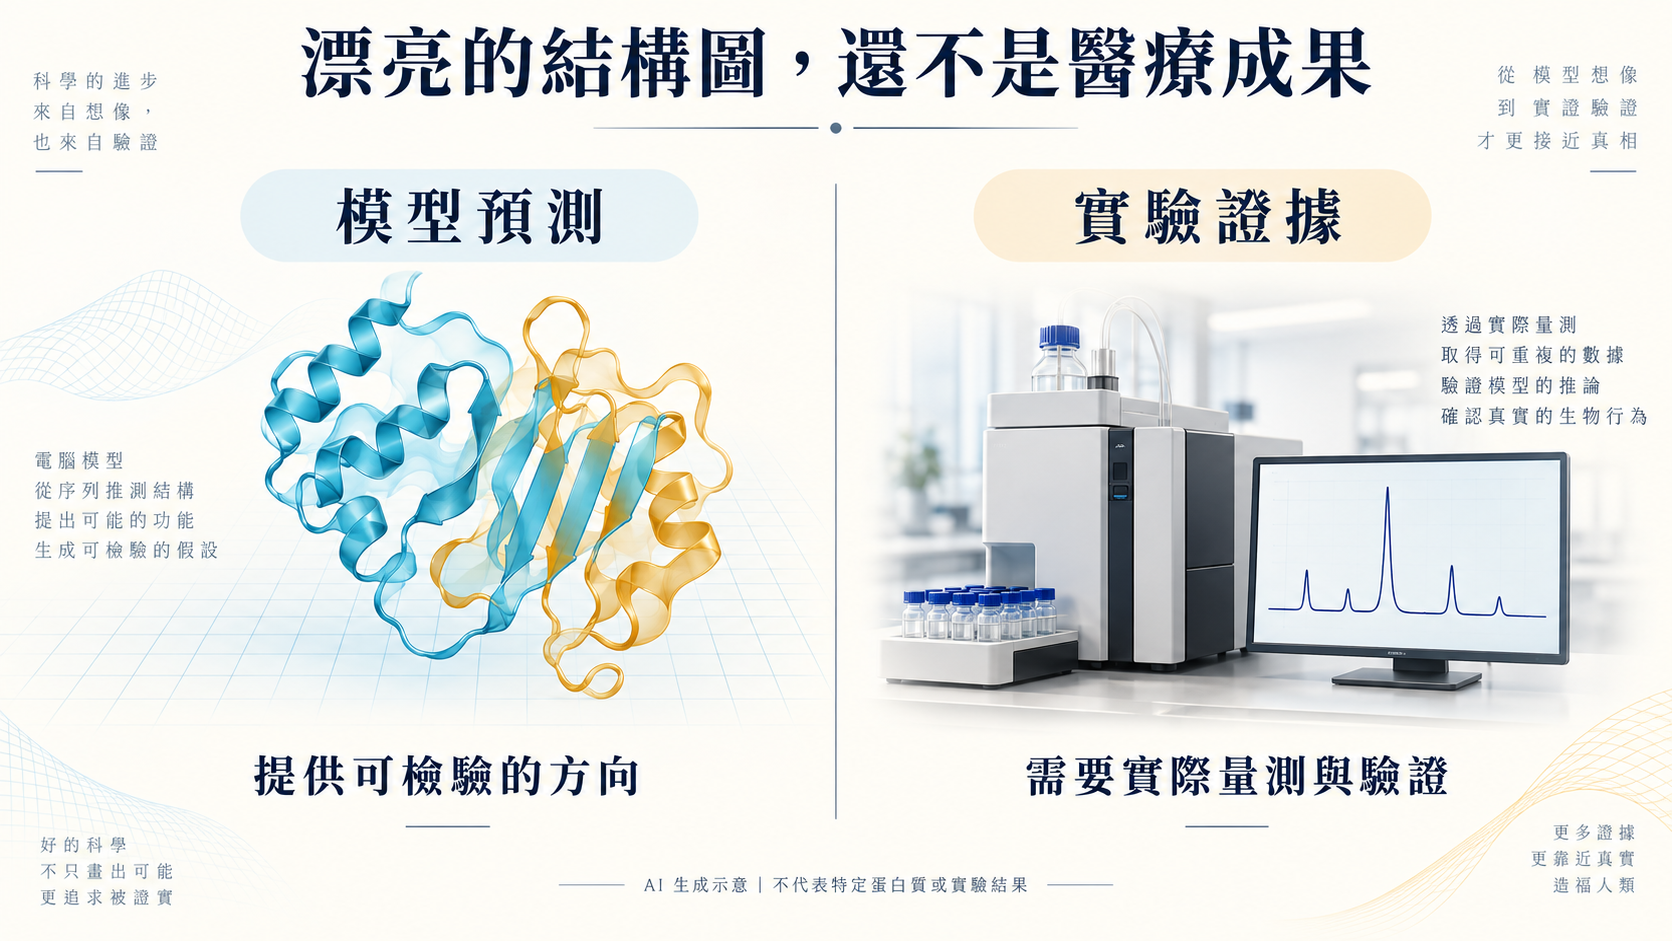
文章中的配圖也遵守同一個界線:它們是 AI 生成的教學概念示意,幫助理解流程,沒有採用特定蛋白質的實測結構,也不代表任何實驗結果。
開放資料的價值,在於讓下一個人接著問
這次資料分享值得關注,是因為研究的起點不必每次都從零開始。EMBL 表示,開放資源也希望降低資源較少地區研究者的門檻,並涵蓋較少被研究的病毒。[4]
瑭宜的觀察是:真正值得學習的 AI 工作方式,不是把「生成了」直接當成「完成了」,而是保留來源、說清限制,讓下一位使用者能判斷哪些地方可以沿用、哪些地方需要驗證。這個習慣,對做科學、做內容,甚至做企業內部自動化,都有參考價值。
這則消息可以讓人期待,但期待應該放在正確的位置:AI 先提供可研究的形狀與方向,科學家再用證據決定它能走多遠。
資料查核:2026 年 9 月 26 日。本文依官方公告、資料庫更新說明及公開專案文件整理,未自行重跑模型或驗證資料集。文中 [1]–[4] 對應下列原始來源。
資料來源
- [1] NVIDIA|How Open Science Can Help Researchers Prepare for the Next Pandemic
- [2] AlphaFold Database|September 2026 database update
- [3] NVIDIA BioNeMo Structure Prediction Pipeline|README
- [4] EMBL|AlphaFold Database adds viral protein complexes to support pandemic preparedness
作者:林政賢(導演 · Gen AI 創作者兼工程師 · 瑭宜影像創意工作室創辦人)