
NVIDIA가 그리는 바이러스 단백질의 ‘입체 지도’: AI 예측 다음에 과학자가 해야 할 일
林政賢 Zheng-Xian Lin ·
AI가 바이러스 단백질의 입체 형태를 예측할 수 있다면 백신도 버튼 하나로 만들 수 있을까요? 실험실 문을 닫기에는 아직 이릅니다. 이번 NVIDIA 소식은 연구자가 살펴보고 비교할 수 있는 지도를 마련했다는 의미에 가깝습니다. 탐색할 방향을 알려 주지만, 여정 전체를 대신해 주지는 않습니다.
이번에 공개된 것은 무엇일까요?
NVIDIA는 2026년 9월 24일 Google DeepMind, EMBL-EBI 및 다른 연구팀과 협력해 2,800종이 넘는 바이러스의 단백질 복합체 예측 구조를 AlphaFold Database를 통해 연구자에게 공개한다고 발표했습니다. [1]
‘복합체’는 여러 부품으로 이루어진 작은 팀이라고 생각하면 됩니다. 연구자는 단백질 하나의 모양뿐 아니라 다른 단백질과 어떻게 결합할 수 있는지도 알고 싶어 합니다. 여기서 입체 모델은 컴퓨터의 예측 결과이지, 모든 조합을 실험으로 촬영한 사진이 아닙니다.
데이터베이스 업데이트에 따르면, 사람의 건강과 관련된 23개 바이러스 과에 속하는 바이러스 프로테옴 2,812개를 분석해 신뢰도가 높은 이종이량체 5,279개와 동종이량체 2,749개를 생성했습니다. 쉽게 말해 전자는 서로 다른 두 단백질의 조합이고, 후자는 같은 단백질끼리의 짝입니다. [2]
이 숫자들이 세는 대상은 서로 다릅니다. ‘분석한 프로테옴의 수’를 ‘새로 발견한 바이러스 종류의 수’로 바꿔 쓸 수 없으며, 구조의 수가 사용 가능한 약의 수를 뜻하는 것도 아닙니다.
NVIDIA의 역할은 보기 좋은 구조를 계산하는 데 그치지 않습니다
NVIDIA는 BioNeMo Structure Prediction Pipeline도 공개했습니다. 프로젝트 설명에 따르면 서열 데이터 전처리, 구조 예측, 후속 품질 평가를 GPU 클러스터에서 실행할 수 있는 작업 흐름으로 연결합니다. [3]
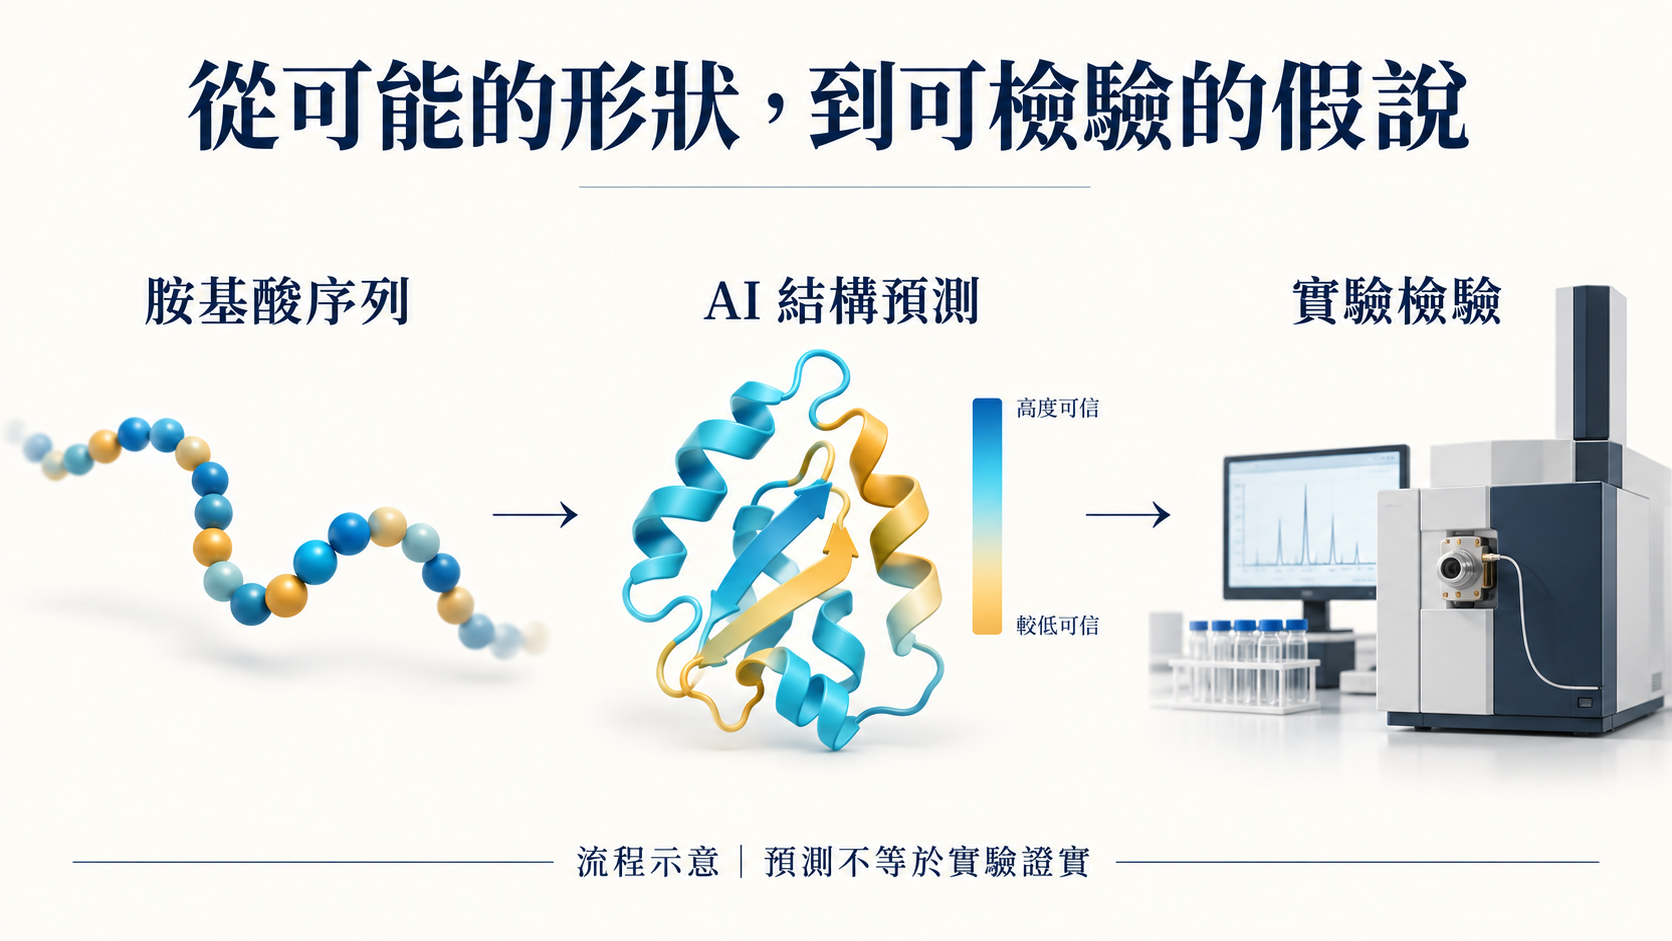
이는 AI의 가치를 다른 관점에서 보게 합니다. 중요한 것은 모델 자체뿐 아니라 데이터를 준비하는 방법, 결과를 확인하는 방법, 다른 사람이 작업을 이어받을 수 있는지입니다. 영상이나 이미지 제작을 해 본 사람이라면 그림 한 장을 만드는 것과 인계 가능한 제작 과정을 갖추는 것이 다르다는 점에 익숙할 것입니다.
다만 코드가 공개되었다고 해서 가정용 컴퓨터로 전체 과정을 쉽게 재실행할 수 있는 것은 아닙니다. 프로젝트가 제시한 환경에는 Slurm 클러스터와 메모리가 최소 80GB인 NVIDIA GPU 등이 포함됩니다. 일반 독자에게 기존 데이터를 살펴보는 일과 예측 파이프라인 전체를 직접 실행하는 일은 서로 다른 수준의 자원을 요구합니다. [3]
구조 그림 하나가 모든 질문에 답하지는 못합니다
EMBL은 예측 구조가 단백질의 형태와 상호작용 가능성을 보여 줄 수 있지만, 그 정보만으로 바이러스의 실제 행동이나 돌연변이의 영향을 판단할 수는 없다고 설명합니다. 여전히 실험 연구가 필요합니다. [4]
따라서 뉴스의 ‘높은 신뢰도’는 특정 예측에 대한 모델의 확신으로 이해하는 것이 적절합니다. 백신의 유효율이나 어떤 치료의 안전성과 효과가 확인되었다는 뜻이 아닙니다. 이를 뒤섞으면 이야기는 흥미로워질지 몰라도 정보는 부정확해집니다.
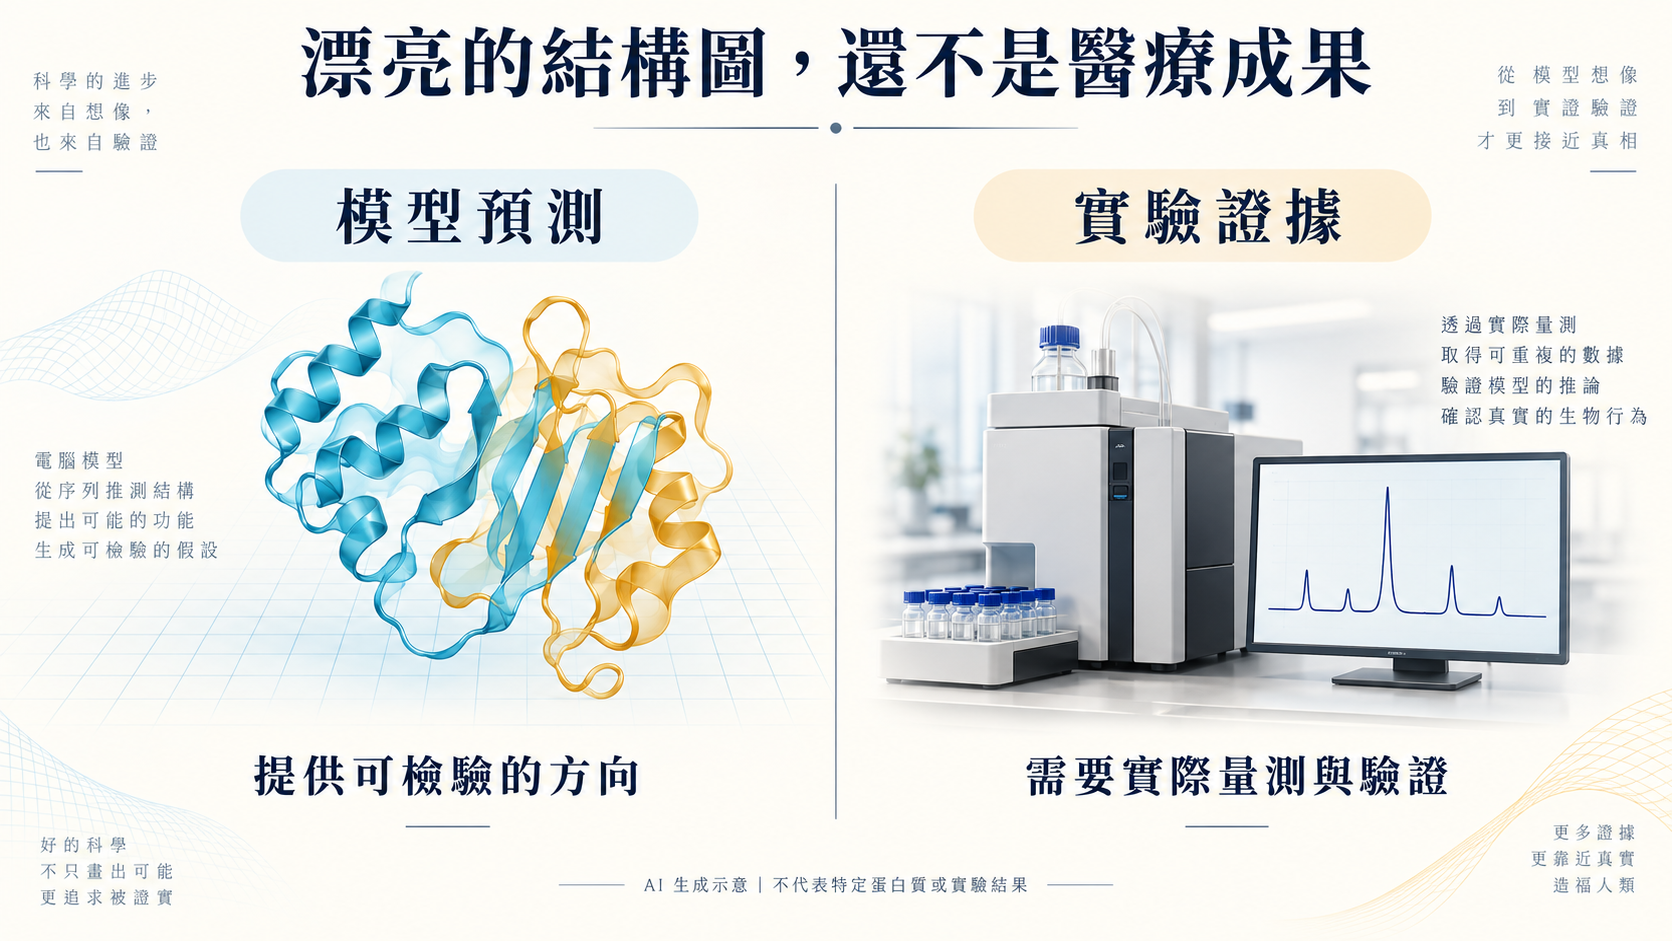
이 글의 이미지에도 같은 원칙을 적용했습니다. 과정을 이해하도록 돕는 AI 생성 교육용 개념도이며, 특정 단백질의 실측 구조를 사용하거나 실험 결과를 나타내는 것이 아닙니다.
공개 데이터의 가치는 다음 연구자가 질문을 이어 갈 수 있다는 데 있습니다
이번 공개가 주목할 만한 이유는 연구를 매번 처음부터 시작하지 않아도 된다는 데 있습니다. EMBL은 자원이 부족한 지역 연구자의 진입 장벽을 낮추고 연구가 상대적으로 적은 바이러스도 다루는 것을 목표로 한다고 밝혔습니다. [4]
탕이(TangYi)가 주목하는 AI 활용 방식은 ‘생성했다’를 곧바로 ‘완성했다’로 여기지 않는 것입니다. 출처를 남기고 한계를 설명해 다음 사용자가 재사용할 부분과 검증할 부분을 판단할 수 있도록 하는 태도입니다. 이러한 습관은 과학, 콘텐츠 제작, 기업 내부 자동화에도 도움이 됩니다.
기대할 만한 소식이지만 기대의 방향은 분명해야 합니다. AI가 연구할 형태와 방향을 제시하면, 과학자가 증거를 통해 그 가능성이 어디까지 이어지는지 확인합니다.
자료 확인일: 2026년 9월 26일. 공식 발표, 데이터베이스 업데이트 안내, 공개 프로젝트 문서를 바탕으로 작성했습니다. 모델을 직접 재실행하거나 데이터셋을 독립적으로 검증하지 않았습니다. 본문의 [1]~[4]는 아래 원문 출처에 해당합니다.
출처
- [1] NVIDIA|How Open Science Can Help Researchers Prepare for the Next Pandemic
- [2] AlphaFold Database|September 2026 database update
- [3] NVIDIA BioNeMo Structure Prediction Pipeline|README
- [4] EMBL|AlphaFold Database adds viral protein complexes to support pandemic preparedness
저자:林政賢(감독 · Gen AI 크리에이터 겸 엔지니어 · 탕이 스튜디오 창업자)